Modèle Kano : le guide complet pour les équipes produit
Guide complet du modèle Kano : 5 catégories avec exemples, questionnaire fonctionnel et dysfonctionnel, grille d'interprétation et étude menée pas à pas.
Par l’équipe RoadmapHero · Mis à jour le · 8 min de lecture
L’essentiel
- Le modèle Kano, publié en 1984 par Noriaki Kano, classe les fonctionnalités selon l’effet de leur implémentation sur la satisfaction, plutôt que sur une échelle linéaire unique.
- Kano distingue cinq catégories : Must-be (attentes de base), Performance (plus, c’est mieux), Attractive (delighters), Indifférente et Reverse (fonctionnalité qui agace).
- Une étude Kano pose une question fonctionnelle et une dysfonctionnelle par fonctionnalité, traduit chaque paire de réponses via une grille et vise 15 à 30 répondants par segment.
- Les catégories Kano s’érodent avec le temps, d’Attractive à Performance puis Must-be : rafraîchissez les études tous les 12 à 24 mois et combinez-les à un framework de scoring.
Le modèle Kano répond à une question que les frameworks de scoring ignorent : quel effet cette fonctionnalité aura-t-elle réellement sur la satisfaction ? Toutes les fonctionnalités ne créent pas de la valeur de la même manière. Certaines sont attendues en silence et ne se remarquent qu'en leur absence ; d'autres paient linéairement ; quelques-unes déclenchent un enthousiasme disproportionné. Confondre ces types mène aux échecs produit classiques : peaufiner des « delighters » pendant qu'un basique est cassé, ou sur-investir dans des fonctionnalités dont personne ne veut. Ce guide couvre les cinq catégories avec des exemples de produits connus, le questionnaire et sa grille d'interprétation, un protocole d'étude pas à pas, et l'exploitation des résultats dans la priorisation.
Qu'est-ce que le modèle Kano ?
Publié en 1984 par le professeur Noriaki Kano, le modèle rompt avec l'intuition d'une satisfaction linéaire (« plus de fonctionnalités = utilisateurs plus contents »). Il positionne chaque fonctionnalité sur deux dimensions indépendantes : son niveau d'implémentation (d'absente à excellente) et la satisfaction produite (de la frustration à l'enchantement). Selon la forme de la courbe qui relie les deux, la fonctionnalité tombe dans l'une des cinq catégories. La conséquence pratique est majeure : la stratégie d'investissement diffère par catégorie. On n'« améliore » pas une Must-be comme on améliore une Performance, et les delighters obéissent à une économie entièrement différente.
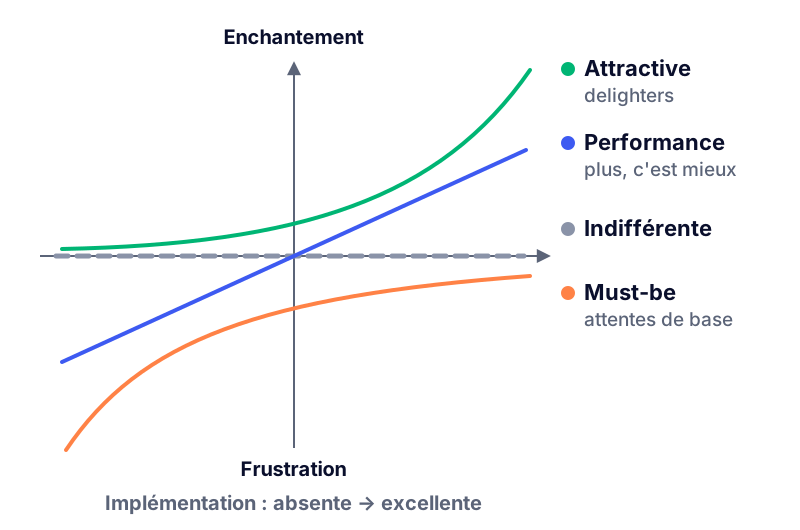
Les 5 catégories Kano, avec exemples de produits connus
1. Must-be (attentes de base)
Absente → forte insatisfaction. Présente → rien : l'utilisateur la tient pour acquise. Aucun client d'hôtel ne félicite la chambre pour son eau chaude, mais son absence ruine le séjour. Côté produit : réinitialisation de mot de passe, données jamais perdues, paiement par carte sur un site e-commerce, freins d'une voiture. Stratégie : atteindre le standard, puis cesser d'investir — la perfection n'y achète aucune satisfaction supplémentaire.
2. Performance (linéaire, « plus, c'est mieux »)
La satisfaction croît avec la quantité livrée. Autonomie d'un ordinateur portable, vitesse d'upload, quota de stockage, pertinence des résultats de recherche, consommation d'un véhicule. Ce sont les dimensions que les clients comparent consciemment entre concurrents, et celles où logent les paliers de pricing. Stratégie : investir pour rester compétitif sur les dimensions que votre segment mesure.
3. Attractive (excitement, delighters)
Absente → aucune plainte, puisque personne ne l'attendait. Présente → enchantement disproportionné. Le pinch-to-zoom du premier iPhone, les messages de chargement espiègles de Slack, l'autocomplétion IA de Notion à ses débuts. Stratégie : quelques delighters bien choisis différencient plus que dix fonctionnalités moyennes — mais ils ne fonctionnent que sur des basiques solides.
4. Indifférente
Présente ou absente, l'utilisateur s'en moque. Une part importante de la plupart des backlogs vit silencieusement ici — réglages que personne ne modifie, badges que personne ne lit. Le premier retour sur investissement d'une étude Kano est souvent la liste des fonctionnalités planifiées qu'elle révèle Indifférentes avant qu'elles ne consomment un trimestre de développement.
5. Reverse (à rebours)
Certains utilisateurs sont activement agacés par la présence de la fonctionnalité : vidéos en lecture automatique, gamification appuyée dans un outil professionnel, assistant qui surgit sans y être invité. Les classifications Reverse varient souvent par segment — les power users jugent fréquemment Reverse les assistants simplificateurs que les débutants adorent.
Le questionnaire Kano : question fonctionnelle et dysfonctionnelle
La méthode Kano ne demande pas « voulez-vous cette fonctionnalité ? » — tout le monde répond oui. Elle pose une paire de questions par fonctionnalité :
Forme fonctionnelle : « Si l'application exportait votre roadmap en PDF, qu'en penseriez-vous ? »
Forme dysfonctionnelle : « Si l'application n'exportait PAS votre roadmap en PDF, qu'en penseriez-vous ? »
Les deux utilisent les cinq mêmes options de réponse : j'adore / c'est un prérequis pour moi / neutre / je peux m'en accommoder / cela me déplaît. Toute la valeur est dans la combinaison : un répondant neutre sur la présence mais gêné par l'absence décrit une Must-be ; un répondant ravi de la présence et neutre sur l'absence décrit une Attractive. Rédigez des descriptions concrètes, au niveau du bénéfice (ce que l'utilisateur peut faire, pas comment c'est construit), et testez au maximum 15 à 20 fonctionnalités par questionnaire pour éviter la fatigue.
La grille d'interprétation
La paire de réponses de chaque répondant se traduit en catégorie via cette grille (réponse fonctionnelle en ligne, dysfonctionnelle en colonne) :
Fonctionnelle \ Dysfonctionnelle | J'adore | Prérequis | Neutre | M'accommode | Me déplaît |
|---|---|---|---|---|---|
J'adore | Douteux | Attractive | Attractive | Attractive | Performance |
Prérequis | Reverse | Indifférente | Indifférente | Indifférente | Must-be |
Neutre | Reverse | Indifférente | Indifférente | Indifférente | Must-be |
M'accommode | Reverse | Indifférente | Indifférente | Indifférente | Must-be |
Me déplaît | Reverse | Reverse | Reverse | Reverse | Douteux |
« Douteux » signale des réponses contradictoires (adorer à la fois la présence et l'absence) — le plus souvent une question mal lue ; on les écarte. Agrégez ensuite sur l'ensemble des répondants et attribuez à chaque fonctionnalité sa catégorie la plus fréquente. En cas de quasi-égalité, rapportez les deux : un partage 45 % Performance / 40 % Attractive est en soi un enseignement sur un marché en transition.
Mener une étude Kano pas à pas
Choisir 8 à 15 fonctionnalités à tester. Des candidates de la roadmap, des demandes controversées, plus une ou deux fonctionnalités déjà livrées (comme points de calibration).
Rédiger les paires de questions. Au niveau du bénéfice, sans jargon, une seule capacité par question. Testez-les sur deux collègues non-PM.
Recruter les répondants par segment. 15 à 30 par segment. Votre base de feedback est le vivier naturel — les utilisateurs qui ont déjà donné leur avis répondent bien plus volontiers, comme détaillé dans notre guide de la gestion du feedback client.
Ajouter une question d'importance (optionnelle mais recommandée) : « quelle importance pour vous, de 1 à 9 ? ». Elle sépare les Must-be forts des faibles et départage les égalités.
Diffuser le questionnaire. Moins de 10 minutes, sinon le taux de complétion s'effondre.
Dépouiller avec la grille, segment par segment. Cherchez les divergences de catégorie entre personas avant de les noyer dans la moyenne.
Approfondir en qualitatif. Cinq courtes interviews utilisateurs sur les résultats surprenants (« pourquoi notre fonctionnalité phare est-elle Indifférente ? ») valent mieux que davantage de volume.
Alimenter la roadmap. Traduisez les catégories en décisions de priorisation (section suivante) et datez l'étude — les résultats périment.
L'érosion des attentes : l'excitement devient must-be
L'enseignement le plus stratégique de Kano : les catégories se dégradent. Le delighter d'hier devient le différenciateur d'aujourd'hui et le prérequis de demain. L'appareil photo des smartphones est passé d'Attractive (2003) à Performance (la course aux mégapixels) puis à Must-be (aucun téléphone ne sort sans). En SaaS : le SSO, la collaboration temps réel et l'assistance IA glissent en ce moment même le long de cette courbe. Deux conséquences opérationnelles :
Rafraîchir les études tous les 12 à 24 mois — un résultat Kano de 2022 relève de l'archéologie.
Budgéter l'érosion : vos différenciateurs ont besoin d'un pipeline de remplacement, car ils cesseront de différencier. C'est une entrée majeure de la stratégie produit, pas seulement du tri de backlog.
Exploiter les résultats Kano dans la priorisation
Kano est un modèle de recherche, pas une formule de classement — il ignore l'effort et la valeur business. Le mode d'emploi standard pour le combiner à un scoring :
Les Must-be cassées ou manquantes passent devant tout : ce sont des générateurs de churn, quel que soit leur score.
Les Performance se départagent via votre framework de scoring (RICE, WSJF, HeroScore), les données Kano consolidant l'estimation d'Impact.
Les Attractive reçoivent un créneau protégé — une par cycle, par exemple — car le pur calcul valeur/effort les sous-évalue systématiquement (leur Reach est inconnaissable avant le lancement).
Les Indifférentes sont coupées, poliment, données à l'appui.
Les Reverse déclenchent une revue de design : rendre optionnel, segmenter, ou retirer.
Exploiter les enseignements Kano dans RoadmapHero
Une étude Kano n'est utile que si ses conclusions survivent au contact du backlog. Dans RoadmapHero, les équipes attachent la catégorie Kano à chaque ticket via un champ personnalisé, et laissent le HeroScore arbitrer : ce score multi-critères configurable pondère la valeur business liée aux OKR, la valeur utilisateur alimentée par Customer Voice (où vit déjà le feedback qui a motivé l'étude, relié feature par feature), l'effort, le risque et l'urgence. Une Must-be cassée se manifeste par une pression utilisateur et une urgence élevées ; une Indifférente expose son faible poids utilisateur à quiconque demande pourquoi elle a été coupée. La roadmap qui en résulte se partage en un clic, avec des viewers illimités : le « pourquoi » de chaque priorité reste visible. Essai gratuit, tarifs transparents en euros, sans engagement.
Questions fréquentes
Qui a créé le modèle Kano ?
Le professeur Noriaki Kano, chercheur japonais en management de la qualité, a publié le modèle en 1984. Son intuition clé : la satisfaction client n'est pas une échelle linéaire unique — certaines fonctionnalités créent de la satisfaction quand elles sont présentes, d'autres ne créent que de l'insatisfaction quand elles manquent.
Combien d'utilisateurs faut-il pour une étude Kano ?
Visez 15 à 30 répondants par segment comme minimum pratique ; en dessous, une réponse atypique fausse la catégorisation. Si vous servez des personas distincts, analysez-les séparément : une fonctionnalité peut être Must-be pour les admins et Indifférente pour les utilisateurs finaux.
Quelle différence entre une fonctionnalité Must-be et Performance ?
Une Must-be provoque une forte insatisfaction quand elle manque, mais aucune satisfaction supplémentaire quand elle est là (les basiques attendus, comme la réinitialisation de mot de passe). Une Performance évolue à peu près linéairement : plus vous en donnez — vitesse, stockage, précision — plus l'utilisateur est satisfait, et inversement.
Une fonctionnalité peut-elle changer de catégorie Kano avec le temps ?
Oui, et presque toujours dans le même sens : les fonctionnalités Attractive s'érodent en Performance, puis en Must-be à mesure que le marché les banalise. Le Wi-Fi gratuit à l'hôtel et l'appareil photo des smartphones ont suivi ce chemin. D'où la nécessité de rafraîchir une étude Kano tous les 12 à 24 mois.
Le modèle Kano est-il un framework de priorisation comme RICE ?
Pas exactement. Kano classe les fonctionnalités selon leur effet sur la satisfaction, mais ignore l'effort et la valeur business. Il sert d'abord d'entrée de recherche pour les frameworks de scoring : sécuriser les Must-be, investir sur les Performance de façon compétitive, et choisir quelques Attractive pour se différencier.