Méthode RICE : le guide complet de la priorisation
Maîtrisez la méthode RICE : Reach, Impact, Confidence, Effort avec barèmes, exemple chiffré complet, erreurs classiques et automatisation du scoring.
Par l’équipe RoadmapHero · Mis à jour le · 9 min de lecture
L’essentiel
- RICE est une méthode de priorisation créée chez Intercom par Sean McBride, qui score chaque élément du backlog selon la formule (Reach × Impact × Confidence) / Effort.
- Reach compte les personnes touchées sur une période fixe, Impact suit un barème de 3 à 0,25, Confidence vaut en général 100 %, 80 % ou 50 %, et Effort se mesure en personnes-mois.
- Plus le score RICE est élevé, plus la valeur par unité d’effort est forte, mais un score n’a de sens que comparé aux autres items d’un même backlog scorés avec les mêmes barèmes.
- RICE ignore la criticité temporelle et pénalise les paris stratégiques sur de petits segments : utilisez-le pour éclairer la décision et rescorez le haut du backlog chaque mois.
La méthode RICE est le framework de priorisation le plus utilisé en product management, et ce n'est pas un hasard : elle permet de comparer des items de backlog très différents — une intégration, un correctif UX, une expérimentation pricing — avec un seul chiffre. Ce guide couvre tout : les quatre facteurs avec des barèmes concrets, un exemple chiffré complet (trois fonctionnalités scorées pas à pas), les erreurs classiques (faux Reach, Confidence théâtrale) et la comparaison avec MoSCoW, WSJF ou la matrice valeur/effort.
Qu'est-ce que la méthode RICE ?
RICE a été conçue chez Intercom par Sean McBride pour classer les initiatives produit de façon objective. La formule :
Score RICE = (Reach × Impact × Confidence) / Effort
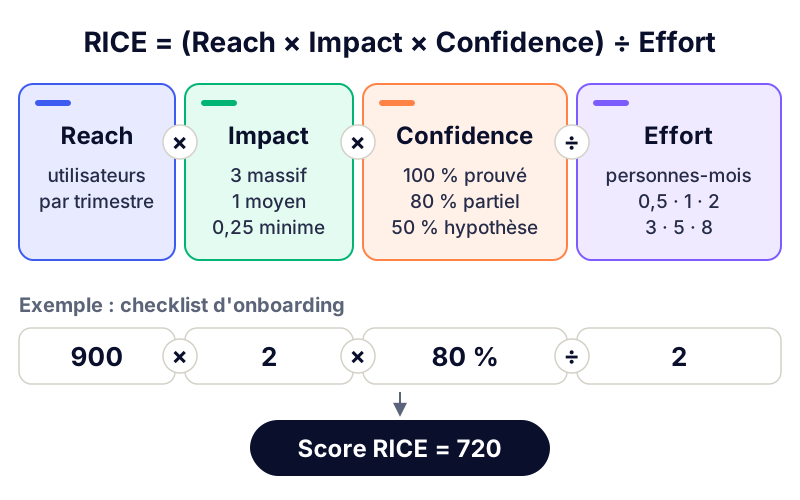
Le numérateur estime la valeur totale attendue (combien de personnes, quelle amplitude par personne, pondérée par votre niveau de certitude). Le dénominateur est le coût de réalisation. Le résultat se lit comme une « valeur par unité d'effort » : plus il est élevé, plus l'item mérite de passer devant. Contrairement à un classement au jugé, chaque donnée d'entrée est une affirmation que l'on peut challenger, sourcer et réviser. C'est tout l'intérêt de RICE : transformer la priorisation d'un rapport de force en une revue d'hypothèses.
Les 4 facteurs en détail, avec barèmes
Reach — combien de personnes, sur une période
Le Reach est le nombre d'utilisateurs (ou de clients, ou de comptes) concernés par l'item sur une fenêtre de temps définie — en général le trimestre. Choisissez une fenêtre unique pour tout le backlog, sinon les scores ne sont plus comparables. Bonnes sources : l'analytics (combien d'utilisateurs ouvrent cet écran par trimestre ?), le volume de tickets support, le nombre de clients ayant demandé la fonctionnalité, les volumes d'inscription pour les sujets d'acquisition.
« 1 800 utilisateurs ouvrent l'écran d'export chaque trimestre » → Reach = 1 800.
« 40 de nos 300 comptes ont demandé le SSO » → Reach = 40 comptes (scorez ensemble les items au niveau compte).
Jamais « tous nos utilisateurs », sauf si l'item touche réellement chaque session.
Impact — quelle amplitude par personne
L'Impact estime à quel point l'item fait bouger votre objectif pour chaque personne touchée. Comme c'est difficile à mesurer précisément, Intercom utilise une échelle fermée :
3 — impact massif (change la décision ou le workflow de l'utilisateur)
2 — impact fort
1 — impact moyen
0,5 — impact faible
0,25 — impact minime
Rattachez l'échelle à un objectif réel (« impact sur le taux d'activation », « impact sur le churn »), pas à une « valeur » vague. Un même item peut valoir 3 pour la rétention et 0,25 pour l'acquisition : décidez contre quel objectif vous scorez.
Confidence — quel niveau de certitude
La Confidence tempère l'enthousiasme. C'est un pourcentage qui reflète la qualité de vos preuves sur le Reach et l'Impact :
100 % — données quantitatives pour le Reach et preuve testée pour l'Impact (expérimentation, recherche utilisateur solide).
80 % — données sur un facteur, jugement éclairé sur l'autre.
50 % — hypothèse plausible, peu d'éléments.
En dessous de 50 % — vous devinez ; faites de la discovery avant de scorer.
Tenez-vous à ces trois ou quatre paliers. Une confidence à « 73 % » relève du théâtre de précision : personne ne sait défendre l'écart entre 73 % et 68 %.
Effort — le coût total en personnes-mois
L'Effort est le travail total de toutes les personnes impliquées — produit, design, développement, QA — exprimé en personnes-mois (ou en personnes-semaines pour un backlog rapide ; là encore, une seule unité pour tout). Estimez grossièrement : 0,5, 1, 2, 3, 5, 8. RICE ne récompense pas la fausse précision, et une estimation relative suffit largement à placer un item sur cette échelle.
Exemple chiffré : 3 fonctionnalités scorées pas à pas
Imaginons un SaaS B2B avec 4 000 utilisateurs actifs mensuels, dont l'objectif du trimestre est d'améliorer l'activation et l'expansion. Trois candidats se disputent le prochain cycle :
Checklist d'onboarding. L'analytics montre ~900 nouveaux inscrits par trimestre, tous exposés au premier parcours → Reach = 900. Les interviews ont révélé de la confusion en première session et un prototype a bien testé → Impact = 2, Confidence = 80 %. Design + développement ≈ 2 personnes-mois.
Intégration Slack. 1 200 utilisateurs appartiennent à des comptes qui ont répondu « on vit dans Slack » au dernier sondage → Reach = 1 200. Elle supprime une friction mineure sans changer les comportements → Impact = 1. La donnée de sondage est solide → Confidence = 100 %. Intégration + réglages de notifications ≈ 3 personnes-mois.
Dashboard analytics admin. Seuls les administrateurs de compte l'utiliseraient : ~150 par trimestre → Reach = 150. Pour eux, il pourrait être décisif au renouvellement → Impact = 3, mais la preuve tient en deux anecdotes commerciales → Confidence = 50 %. Il exige un pipeline de données ≈ 4 personnes-mois.
Fonctionnalité | Reach | Impact | Confidence | Effort | Score RICE |
|---|---|---|---|---|---|
Checklist d'onboarding | 900 | 2 | 80 % | 2 | 720 |
Intégration Slack | 1 200 | 1 | 100 % | 3 | 400 |
Dashboard admin | 150 | 3 | 50 % | 4 | 56 |
Le calcul : (900 × 2 × 0,8) / 2 = 720 ; (1 200 × 1 × 1) / 3 = 400 ; (150 × 3 × 0,5) / 4 = 56. Observez ce que fait le score : le dashboard semblait excitant (« Impact 3 ! »), mais un Reach faible, des preuves fragiles et un effort élevé le font chuter. La bonne réaction n'est pas de l'enterrer, mais de faire monter sa Confidence avec quelques interviews d'admins, puis de rescorer. RICE indique où investir en discovery, pas seulement quoi construire.
Forces et limites de RICE
Forces
Comparabilité : des items hétérogènes atterrissent sur une seule échelle.
Incertitude explicite : la Confidence est le seul facteur des frameworks grand public qui pénalise la devinette.
Peu coûteux : 5 minutes par item une fois les barèmes posés.
Propice au débat sain : les parties prenantes contestent une donnée (« pourquoi Reach 900 ? ») au lieu de rejouer toute la décision.
Limites
RICE optimise la largeur d'audience : les paris stratégiques sur un petit segment (features enterprise, nouveau marché) scorent structurellement bas.
Il ignore la criticité temporelle : une échéance réglementaire ou une fenêtre concurrentielle n'apparaît nulle part dans la formule — c'est là que le WSJF et son Cost of Delay est plus fort.
Dépendances, réduction de risque et travail de plateforme exigent une convention d'Impact délibérée, sous peine d'être affamés.
Garbage in, garbage out : avec des Reach inventés, RICE ne fait que blanchir des opinions en décimales.
Variantes utiles de RICE
ICE — Impact × Confidence × Ease, sans Reach. Plus rapide, adapté aux expérimentations growth qui visent toutes le même funnel. Voir le guide du scoring ICE.
RICE pondéré par objectif — scorez l'Impact par OKR et pondérez les objectifs (ex. la rétention compte double ce trimestre).
Reach en revenu — en B2B, remplacez le nombre d'utilisateurs par l'ARR concerné. Utile quand 5 comptes pèsent la moitié du chiffre d'affaires.
Effort par équipe — séparez l'effort design et développement quand l'un des deux est le goulot d'étranglement ; divisez par la ressource contrainte.
Les erreurs classiques qui faussent le score RICE
Le faux Reach : « nos 4 000 utilisateurs » pour une fonctionnalité que seuls les power users trouveront. Le Reach vient de l'analytics ou de demandes comptées, pas de l'espoir.
La Confidence théâtrale : tout le monde met 80 % parce que 50 % ressemble à un aveu. Si rien ne score jamais 50 %, votre facteur Confidence est mort.
Le score rétro-ajusté : décider d'abord, scorer ensuite pour justifier. Le score devient un décor politique, et l'équipe le remarque immédiatement.
Les fenêtres de temps mélangées : Reach mensuel pour un item, annuel pour un autre. Les scores ne sont plus comparables.
Classer uniquement au score : RICE alimente le jugement, il ne le remplace pas. Un pari stratégique mal noté peut rester le bon choix — mais dites-le explicitement au lieu de gonfler ses chiffres.
Scorer une seule fois : les estimations se périment. Rescorez le haut du backlog chaque mois, dans le cadre d'un vrai rituel de priorisation du backlog.
RICE vs les autres frameworks de priorisation
Framework | Idéal pour | Par rapport à RICE |
|---|---|---|
MoSCoW | Cadrer un MVP ou un projet à deadline | Des catégories, pas un classement — plus grossier mais plus rapide avec les parties prenantes |
WSJF | Portefeuilles SAFe, sujets sensibles au temps | Ajoute la criticité temporelle ; plus lourd, échelles entièrement relatives |
Kano | Comprendre les ressorts de la satisfaction | Un modèle de recherche, pas une formule de classement — nourrit de meilleurs Impacts |
Matrice valeur/effort | Alignement rapide en atelier | 2 axes au lieu de 4 facteurs — plus simple, moins rigoureux |
En pratique : utilisez une matrice valeur/effort pour trier une liste d'idées brute, RICE pour classer ce qui survit, et une étude Kano pour consolider vos estimations d'Impact sur les finalistes.
Automatiser le scoring RICE avec HeroScore dans RoadmapHero
Un tableur RICE fonctionne… jusqu'à ce qu'il se désynchronise du backlog. Dans RoadmapHero, le HeroScore applique la même logique directement sur vos tickets : critères configurables de valeur business (reliée à vos OKR), valeur utilisateur (pondérée par le volume de feedback Customer Voice), effort, risque et urgence, chacun avec les poids de votre choix. Vous pouvez reproduire un RICE classique ou l'enrichir de la dimension temporelle qui lui manque. Les scores se mettent à jour quand le feedback et les estimations évoluent, le backlog classé alimente les vues roadmap partagées avec vos parties prenantes, et la priorisation assistée par IA signale les items dont le score paraît incohérent avec les preuves. Essai gratuit, tarifs transparents en euros, sans engagement — et viewers illimités sur les vues partagées.
Questions fréquentes
Qui a inventé la méthode RICE ?
RICE a été popularisée par Sean McBride chez Intercom vers 2016, comme méthode interne de priorisation produit. Elle s'est imposée parce qu'elle met en balance la valeur (Reach × Impact) et le coût (Effort), tout en rendant l'incertitude explicite via la Confidence.
Qu'est-ce qu'un bon score RICE ?
Il n'existe pas de seuil universel : un score RICE n'a de sens que comparé aux autres items du même backlog, scorés avec les mêmes barèmes. Utilisez-le pour classer, pas pour juger un item isolément, et rescorez dès que vos données changent.
À quelle fréquence rescorer son backlog avec RICE ?
Rescorez le top 15–20 du backlog chaque mois, plus tout item dont le Reach, l'Effort ou la Confidence a évolué. Un score RICE calculé une fois puis oublié devient décoratif en un trimestre.
Quelle est la différence entre RICE et ICE ?
ICE (Impact, Confidence, Ease) supprime le Reach et multiplie trois notes au jugé : plus rapide, mais moins rigoureux. RICE oblige à quantifier combien d'utilisateurs sont réellement touchés — précisément là où se cache le vœu pieux.
Peut-on utiliser RICE pour les bugs et la dette technique ?
Oui. Estimez le Reach comme le nombre d'utilisateurs touchés par le bug ou le ralentissement, l'Impact comme la gravité par utilisateur, et l'Effort normalement. Scorer la dette avec la même formule que les features évite qu'elle soit éternellement dépriorisée.