Méthode ICE : prioriser avec Impact, Confiance, Facilité
Découvrez la méthode ICE : notez Impact, Confiance et Facilité pour prioriser vos idées en quelques minutes. Barèmes, exemple chiffré et ICE vs RICE.
Par l’équipe RoadmapHero · Mis à jour le · 8 min de lecture
L’essentiel
- La méthode ICE note chaque idée de 1 à 10 sur l’Impact, la Confiance et la Facilité, puis classe les idées selon la moyenne, ou parfois le produit, des trois notes.
- ICE a été popularisée par Sean Ellis, inventeur du terme « growth hacking », pour les pipelines d’expérimentation où noter une idée en moins d’une minute compte plus que la précision.
- Des barèmes écrits pour chaque critère, par exemple une Confiance de 9 à 10 réservée aux idées déjà validées par un test similaire, sont la meilleure parade contre la subjectivité d’ICE.
- Utilisez ICE pour les expérimentations growth, les backlogs early-stage et le tri des demandes entrantes, et passez à RICE quand la portée varie fortement et se mesure.
La méthode ICE est la façon la plus rapide de prioriser une pile d'idées sans y passer la journée. Chaque idée reçoit trois notes de 1 à 10 — Impact, Confiance, Facilité — et le classement se fait sur le score obtenu. Pas d'usine à gaz Excel, pas d'atelier de deux heures. Cette vitesse n'est pas un raccourci de paresseux : c'est le cœur de la méthode, pensée pour des équipes qui testent des dizaines d'idées par trimestre et ne peuvent pas passer plus de temps à noter une idée qu'à la tester.
La méthode ICE, c'est quoi ?
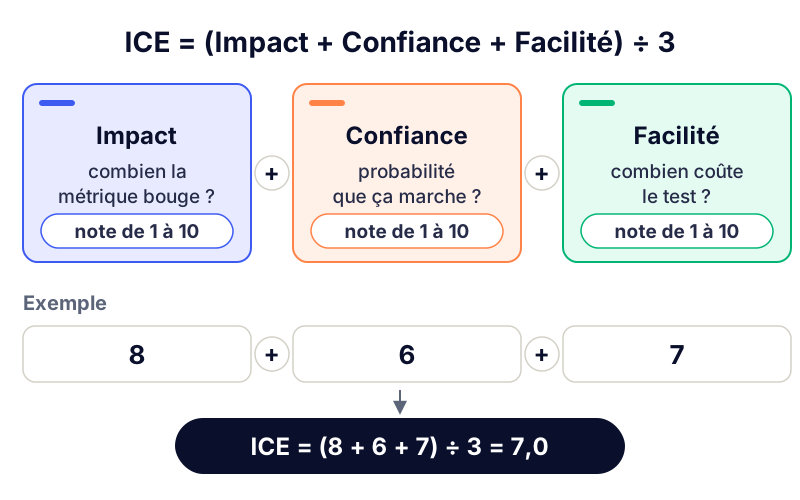
Le scoring ICE évalue chaque idée candidate sur trois questions :
Impact — si ça marche, à quel point la métrique visée bouge-t-elle ? (1 = à peine mesurable, 10 = changement de trajectoire)
Confiance — quelle est la probabilité que ça marche ? Sur quelles preuves : données, feedback client, expérimentations passées, ou simple intuition ?
Facilité — combien coûte le test ou l'implémentation ? (10 = une après-midi, 1 = un trimestre complet)
Le score ICE est généralement la moyenne des trois notes, parfois le produit. Une idée notée Impact 8, Confiance 6, Facilité 7 obtient (8+6+7)/3 = 7,0. On trie ensuite la liste par score décroissant et on attaque par le haut. Le résultat est un classement, pas un verdict : ICE dit quoi regarder en premier, pas quoi livrer.
Origine : Sean Ellis et le growth
ICE a été popularisée par Sean Ellis, l'inventeur du terme « growth hacking » et responsable de la croissance des débuts de Dropbox. Dans un process growth à haute cadence, l'équipe génère bien plus d'idées d'expérimentation qu'elle ne peut en lancer — souvent 50 idées pour 5 créneaux de test hebdomadaires. Il fallait une méthode de scoring assez légère pour que n'importe qui note une idée en moins d'une minute, mais assez structurée pour que la voix la plus forte ne gagne pas à tous les coups.
Cet héritage explique les choix de conception. Les expérimentations growth sont peu coûteuses, réversibles et nombreuses : la vitesse de scoring prime sur sa précision. Si une idée médiocre se glisse en haut de liste, vous perdez un créneau de test d'une semaine — pas un trimestre d'ingénierie. Les équipes produit qui adoptent ICE doivent garder ça en tête : la méthode tolère le bruit parce que son environnement d'origine tolère le bruit.
Barèmes : noter Impact, Confiance, Facilité
Le premier piège d'ICE, ce sont les échelles floues. « Impact 7 » ne veut rien dire tant que l'équipe n'a pas défini ce qu'est un 7. Écrivez vos ancrages une fois pour toutes : chaque session de scoring suivante sera plus rapide et plus cohérente.
Impact (sur une métrique explicite)
1–3 : cosmétique, invisible dans la métrique.
4–6 : gain visible sur une métrique secondaire (ex. +2 à 5 % sur une étape du funnel).
7–8 : gain net sur la métrique principale (ex. +5 à 15 % d'activation).
9–10 : peut changer la trajectoire du produit.
Confiance (fondée sur des preuves, pas sur l'enthousiasme)
1–3 : pure opinion, ou copié chez un concurrent.
4–6 : étayé par du qualitatif (tickets support, interviews).
7–8 : étayé par nos propres données quantitatives.
9–10 : un test similaire a déjà fonctionné chez nous.
Facilité (coût total, pas seulement le dev)
1–3 : plusieurs semaines, plusieurs équipes, migration ou validation juridique.
4–6 : quelques jours pour une squad.
7–8 : une journée ou moins, sans dépendance.
9–10 : changement de config, de wording, test no-code.
Exemple chiffré pas à pas
Une équipe SaaS B2B veut améliorer la conversion essai → payant. Cinq idées candidates, notées en une session de 20 minutes :
Idée | Impact | Confiance | Facilité | ICE |
|---|---|---|---|---|
Checklist d'onboarding in-app | 7 | 8 | 6 | 7,0 |
Email de relance à J+5 de l'essai | 5 | 7 | 9 | 7,0 |
Visite guidée interactive du produit | 8 | 5 | 3 | 5,3 |
Refonte de la page tarifs | 6 | 4 | 5 | 5,0 |
Appel commercial pour chaque inscription | 7 | 6 | 2 | 5,0 |
Deux idées à égalité à 7,0 — et c'est très bien. L'équipe lance d'abord l'email J+5 (Facilité 9 : livré dans la semaine) et démarre la checklist en parallèle. La visite guidée, séduisante en slide, retombe en troisième position une fois la Facilité prise en compte. C'est exactement le rôle d'ICE : faire remonter les gains peu coûteux et bien étayés que l'intuition sous-estime systématiquement.
ICE vs RICE : quand la simplicité gagne
La méthode RICE ajoute une quatrième dimension, le Reach — combien d'utilisateurs sont touchés par période — et divise par l'Effort au lieu de moyenner la Facilité. Cette rigueur supplémentaire a un prix : chaque score RICE exige une estimation de portée, donc de l'analytics, donc du temps.
Critère | ICE | RICE |
|---|---|---|
Temps pour noter un item | < 1 minute | 5 à 15 minutes |
Données nécessaires | Aucune (jugement d'équipe) | Estimations de portée par segment |
Terrain idéal | Expérimentations, backlog early-stage | Backlog produit mature |
Risque principal | Subjectivité | Fausse précision, maintenance lourde |
Règle simple : si vos items touchent des audiences très différentes et que vous savez les mesurer, RICE mérite son surcoût. Si vous êtes avant le product-market fit, ou si vous notez des expérimentations qui visent toutes le même funnel, ICE donne 90 % de la qualité de classement pour 10 % de l'effort. Beaucoup d'équipes démarrent d'ailleurs en atelier avec une simple matrice valeur/effort, puis formalisent avec ICE quand la liste d'idées déborde du tableau blanc.
Les limites de la méthode ICE
Subjectivité : trois notes au doigt mouillé moyennées restent du doigt mouillé. Parade : des barèmes écrits et un scoring en binôme.
Inflation des scores : l'auteur d'une idée note son bébé 8-9-8. Parade : la Confiance est notée par quelqu'un d'autre que l'auteur.
Aucune notion de portée : un correctif pour 2 % des utilisateurs peut dépasser un correctif pour 80 %. Si cette distorsion vous coûte, passez à RICE.
Égalités et tassement : sur une échelle 1-10, des dizaines d'items finissent entre 6 et 7,5. Utilisez ICE pour construire une shortlist, puis tranchez le top 5 en discussion.
La moyenne masque les vetos : Impact 9, Confiance 1, Facilité 9 donne un honorable 6,3. Le produit (81 sur 729 max) expose bien mieux le maillon faible.
Aucun de ces défauts n'est rédhibitoire tant que le score reste un support de conversation, pas une sentence. Une équipe qui lit le classement, débat des surprises et ajuste utilise ICE correctement.
Quand utiliser ICE (et quand éviter)
ICE brille dans trois situations :
Les pipelines d'expérimentation growth — son habitat naturel. Scoring hebdomadaire de la file de tests, re-scoring au fil des résultats.
Les backlogs early-stage — une startup avec 60 idées et zéro historique analytics ne peut pas nourrir RICE honnêtement. ICE transforme le chaos en liste classée en une session : un excellent premier pas avant d'adopter une méthode de priorisation plus complète.
Le tri des demandes entrantes — une passe ICE rapide sur les demandes de fonctionnalités sépare « à creuser » de « à parquer » sans cérémonie.
Évitez ICE pour les paris coûteux et irréversibles (migration de plateforme, refonte du pricing) : ils méritent une analyse plus profonde, business case ou score multi-critères. Notre panorama des meilleurs outils de priorisation en 2026 détaille vers quoi évoluer quand vos besoins mûrissent.
Le scoring ICE dans RoadmapHero
Dans RoadmapHero, vous pratiquez ICE sans tableur : ajoutez Impact, Confiance et Facilité comme critères de scoring, notez chaque item du backlog et triez par score. Quand vous dépassez le cadre d'ICE, les mêmes items alimentent le HeroScore, le score multi-critères personnalisable de RoadmapHero : valeur business reliée aux OKR, valeur utilisateur pondérée par le feedback Customer Voice, effort, risque, urgence. Vous gardez la vitesse d'ICE pour le tri, et gagnez un classement défendable et aligné sur vos objectifs pour les décisions de roadmap — avec une priorisation assistée par IA pour challenger vos notes. Essai gratuit, tarifs transparents en euros, sans engagement.
Questions fréquentes
Que signifie ICE en priorisation ?
ICE signifie Impact, Confidence (confiance) et Ease (facilité). Chaque idée reçoit une note de 1 à 10 sur ces trois critères, puis on calcule la moyenne (ou le produit) des trois. Les scores les plus élevés sont testés ou développés en premier.
Qu'est-ce qu'un bon score ICE ?
Un score ICE est relatif, jamais absolu. Un 7,3 n'a de sens que comparé aux autres items de la même liste, notés par la même équipe avec les mêmes barèmes. Utilisez ICE pour classer un lot d'idées, pas pour juger une idée isolément.
Faut-il multiplier ou moyenner les notes ICE ?
Les deux fonctionnent si vous restez cohérent. La moyenne (I+C+E)/3 garde une échelle familière de 1 à 10. Le produit I×C×E s'étale de 1 à 1 000 et pénalise fortement les items dont une dimension est très faible — un choix que beaucoup d'équipes growth préfèrent.
Quand passer de ICE à RICE ?
Passez à RICE quand la portée (Reach) varie fortement d'un item à l'autre et que vous avez des données pour l'estimer — typiquement un backlog produit mature avec des segments distincts. ICE reste plus adapté aux pipelines d'expérimentations et aux backlogs early-stage sans historique analytics.
À quelle fréquence mettre à jour les scores ICE ?
À chaque nouvelle preuve : résultat d'expérimentation, interviews utilisateurs, spike technique. Pour un backlog growth actif, re-scorer le top 10-15 chaque semaine suffit ; une passe complète mensuelle garde le reste à jour.